Вход в BIOS на ноутбуках HP серий 250/260 G*

Последние ноубуки с UEFI BIOS имеют нетривиальный вход в собственно настройки биоса. Каждый производитель придумывает свой хитрый способ. В такие моменты с теплотой вспоминаешь старые компьютеры, на которых вход был унифицированный с помощью Del.

На днях разбирался с Hewlett Packard HP 260 G2. Он имеет UEFI BIOS, зайти в который ещё надо знать как. Нашёл этот способ и чтобы не забыть сохраню.

Как попасть в BIOS. Сразу после включения Power нажимаем (и отпускаем) ESC, а после быстро F10, которую лучше держать.
Ка попасть в меню загрузки (Boot Order). Аналогично нажимаем ESC, а затем F9.
Управление supervisorctl без рутовых прав

Для разных самописных процессов, которые нужно запускать как демон, есть прекрасный инструмент supervisor. Управление запуском процесса в нём происходит с помощью конфигов предельно простого синтаксиса (и в тоже время покрывающих почти все необходимости) в /etc/supervisor.d/ и команд наподобие:

supervisorctl start myapp
supervisorctl stop myapp
supervisorctl restart myapp

т.е. интерфейс полностью аналогичный управлению демонами в ОС.

Во многих случаях процесс, который запускают как демон, запускается от непривелигерованного пользователя. И от этого же пользователя работают реальные пользователи/разработчики, которым может понадобится управление демоном. Стандартный способ сделать это — через sudo:

sudo supervisorctl restart myapp

Но если это виртуальная машина, в которой supervisor нужен именно для приложений от этого пользователя, то можно сделать и в обход root совсем. Для этого необходимо поправить в /etc/supervisor/supervisord.conf:

[unix_http_server]
file=/var/run/supervisor.sock
chmod=0770
chown=someuser:someuser

После этого supervisor будет управляться из под пользователя. У способа есть недостаток, что теперь supervisor заточен на приложения этого пользователя/группы, но часто это не является препятствием.

Ускорение raid5 md-массивов на запись

RAID5/6-массивы дисков — типичное решение для файловых архивов, к которым много запросов на чтение и мало на запись. Их слабое место: медленные операции записи, в которых для расчёта контрольной суммы требуется чтение со всех томов данных массива. Это приводит не только к медленной записи на массив новых данных, но и к медленному исполнению всех операций предполагающих модификацию раздела, в частности операции удаления. А если ещё и используется дешёвый вариант рейда на основе mdadm, без всяких батареек, кешей и специализированного софта для рейдов, то удаление большого количества файлов становится ну оочень медленной задачей.

Отчасти это можно исправить. raid5 при записи много читает, читает даже больше чем пишет. При удалении модифицируемые данные это структуры затрагиваемых файлов и директорий, в общем-то небольшого количества данных, но изменяемых многократно. Учитывая, что XFS (и другие устойчивые файловые системы тоже) делают это безопасно для отключения питания, т.е. собственно коммитом и через журнал. Поэтому, хороший прирост скорости удаления даёт изменение кеша чтения mdadm:

    echo 16384 > /sys/block/md?/md/stripe_cache_size

Параметр stripe_cache_size по умолчанию имеет значение 256 (страниц по 4Kb), что в большинстве случаев достаточно мало. Максимальное значение — 32768, при этом скорость достаточно хорошая уже при значениях 8192-16384. При увеличении параметра надо учитывать, что это значение в страницах для каждого устройства в рейде и он в результате может занимать весомую часть ОЗУ. Тем не менее, даже если ОЗУ не много, увеличение чаще имеет смысл.

Кроме этого способа, можно увеличить производительность вынесением журнала на отдельный раздел (и тогда раздел данных становится несколько зависимым от другого) или включением разных опций вроде nobarrier, которые сделают ФС быстрой но потенциально нерабочей в случае отключения питания. Это скорее не для продакшн-систем.

Поддомены по маске в CORS

В веб-проектах в последнее время всё активнее и активнее используется размещение разного контента по разным поддоменам. Например, типична ситуация, когда статические файлы размещают на отдельных поддоменах для работы с CDN или использование поддоменов для разных языковых версий сайта, или же для разных географических локаций. Основная часть ресурсов обычно едина для всех отдельных сайтов, как правило это картинки css/js и прочая статика. Чтобы кросс-запросы между поддоменами корректно принимались браузером в плане безопасности, необходимо настроить для CORS заголовки в ответе веб-сервера.

Домены с которых разрешено загружать контент указываются на ресурсе-источнике в заголовке Access-Control-Allow-Origin. В нём можно перечислить явно домены, с которых можно запрашивать контент, или разрешить со всех астериском ‘*’. К сожалению, разрешить поддомены по маске, например *.example.com, простым укаазанием этой маски в заголовке не удастся. Т.е. можно разрешить или всё или перечислять все домены. Что делать если этих доменов много или их неопределённый список и логичнее включить доступ по маске?

В случае использования Nginx как фронтэнда возможно решение, когда необходимый заголовок формируется в зависимости от источника запроса. То есть, будем отдавать разрешающий заголовок только если запрос приходит именно с наших поддоменов. Код для реализации этой идеи получается такой:

  set $cors "";
  if ($http_origin ~* (\.example\.com|\.example\.ru)) {
      set $cors "true";
  }

  if ($cors = "true") {
    add_header 'Access-Control-Allow-Origin' "$http_origin";
    add_header 'Access-Control-Allow-Methods' 'GET, POST, PUT, OPTIONS, DELETE';
    add_header 'Access-Control-Allow-Credentials' 'true';
    add_header 'Access-Control-Allow-Headers' 'User-Agent,Keep-Alive,Content-Type';
  }

  proxy_pass http://backend:8080/;

Его целесообразно вынести в отдельный snippet и включать в те location, с которых берёрется контент для остальных поддоменов. При этом мы не затрагиваем бэкэнд, что экономит производительность.

libmariadbclient18 perl

После обновления MariaDB до версии 10.2 в debian-дистрибутивах в perl-приложениях возникает ошибка

install_driver(mysql) failed: Can't load '/usr/lib/x86_64-linux-gnu/perl5/5.24/auto/DBD/mysql/mysql.so' for module DBD::mysql: /usr/lib/x86_64-linux-gnu/libmariadbclient.so.18: version `libmariadbclient_18' not found (required by /usr/lib/x86_64-linux-gnu/perl5/5.24/auto/DBD/mysql/mysql.so) at /usr/lib/x86_64-linux-gnu/perl/5.24/DynaLoader.pm line 187

Оказывается, это баг MariaDB, о котором можно прочитать в соответствующей статье, в ней же есть и решение. Практическое решение это откат библиотеки libmariadbclient18 до предыдущей версии, в которой она слинкована правильно. При использовании apt/apt-get и официальных репозитариев Марии для этого нужно добавить в файлик /etc/apt/preferences строки

Package: *
Pin: release o=MariaDB,n=stretch
Pin-Priority: 1001

Package: libmariadbclient18
Pin: release o=Debian,n=stretch
Pin-Priority: 1002

и после этого даунгрейдить libmariadbclient18.

PS: Ошибка точно затрагивает мониторинг параметров mysql от Munin, поэтому если «потерялись» графики базы после обновлениях, то причиной является наверняка та, что описана выше.

Поменять почтовый адрес root

Важной частью стабильной работы сервера является мониторинг событий на нём. Кроме специализированных утилит вроде logcheck и прочих автоматических анализаторов логов, есть более простые способы получаения важных событий. В частности, многие демоны и прикладные программы используют отправляют сообщения об ошибках и других важных событиях на почтовый адрес суперпользователя root@hostname самого сервера. В настроенном «из коробки» сервере эта почта складывается или в директорию в домашней директории пользователя или в файл /var/mail/$USER. В обоих случаях почта хранится локально, прочитать её можно вручную локально на сервере, что редко кто делает. Перенаправим эти сообщения на другой почтовый ящик, который регулярно проверяется и читается. Это можно сделать следующими основными способами.

/etc/aliases

Это глобальный способ для любого пользователя в системе. /etc/aliases содержит почтовые алиасы алиасы локальных пользователей. Добавляя/изменяя срочку

root: system@example.com, adm@mydomain.com

получаем перенаправление почты на соответствующие адреса. После изменения файла алиасов необходимо запустить newaliases для принятия изменений.

~/.forward

Перенаправить почту можно и локально, из самого пользователя. Для этого в домашней директории создаём файл .forward и перечисляем там почтовые адреса получателей. Можно также указать и локальный адрес, тогда почта будет уходить на внешние адреса и оставаться в системе тоже.
Этот способ работает и из непривелегированных пользователей, в этом его существенный плюс.

Оба способа зависят от используемого MTA, могут работать не со всеми. Также, если нужно сделать перенаправление на сервере, который ставится как почтовый, то возможно сделать это перенаправление на уровне самого MTA.

Port forward to another server

При переезде сайтов или другого постоянно используемого извне ресурса возникает потребность его доступности как со старого, так и с нового местоположения, пока по сети распространяются новые записи DNS. Сделать это без нарушения целостности данных можно с помощью перенаправления порта. Например, если на NEW_IP_ADDR поднят https-сервер, все актуальные данные уже на нём, то на время переключения DNS редиректить со старого адреса на новый можно так:

iptables -P FORWARD ACCEPT
echo 1 > /proc/sys/net/ipv4/ip_forward
iptables -F
iptables -X
iptables -F -t nat
iptables -X -t nat

iptables -t nat -A PREROUTING -p tcp --dport 443 -j DNAT --to-destination NEW_IP_ADDR:443
iptables -t nat -A POSTROUTING -j MASQUERADE

Этот же способ помогает зеркалировать нужные на другом сервере.

perl5 unescaped left brace deprecated

После частичного обновления дебиановского софта где-то между jessie и stretch при установке пакетов начинает возникать ошибка.

Unescaped left brace in regex is deprecated, passed through in regex; marked by <-- HERE in m/^(.*?)(\\)?\${ <-- HERE ([^{}]+)}(.*)$/ at /usr/share/perl5/Debconf/Question.pm line 72.
Unescaped left brace in regex is deprecated, passed through in regex; marked by <-- HERE in m/\${ <-- HERE ([^}]+)}/ at /usr/share/perl5/Debconf/Config.pm line 30.

Она неопасна, однако, несколько достаёт. Исправляется обновлением debconf до последней версии используемого релиза:

apt-get update
apt-get install debconf

HP SmartArray P410 smartctl

С помощью smartmontools состояние SMART у дисков на контроллере HP SmartArray P410 проверяется следующей командой

smartctl -d sat+cciss,N -x /dev/sda

где N — номер диска.

Выбор компонентов в MS Office 2016

В последнее время у некоторых крупных производителей ПО пошла мода считать себя умнее пользователей. В частности Microsoft в последнем выпуске Office 2016 не даёт возможности в установщике выбрать устанавливаемые компоненты: есть всего одна кнопка Установить, нажатие которой ставит полный комплект. Это, конечно, удобно ряду пользователей, кому больше одной кнопки и не нужно, однако, что делать если пользователю не нужны разные One Note, Publisher или они не пользуются Outlook? Или по ряду причин хотят сохранить место на системном жёстком диске или просто не любят ничего лишнего.

Решение, к счастью, есть. Не совсем тривиальное, но рабочее. Реализуем его на стандартном пакете Home & Business.

Для кастомной установки сначала качаем Office 2016 Deployment Tool, помещаем его в пустую директорию, которая будет в итоге директорией с нашим дистрибутивом. Получаем в итоге 2 файла: setup.exe, configuration.xml. Первый это, очевидно, сам установщик, а второй файл конфигурации, по которому этот установщик работает. Правим его согласно первоисточнику, например, следующим образом:


В этой конфигурации мы явно указали продукт, разрядность, язык и исключили компоненты, которые не нужны (в том числе и те, которых нет в выбранной поставке. Так, на всякий случай). Далее запускаем закачку дистрибутивов выбранных компонентов

setup.exe /download configuration.xml

И после закачки запускаем саму установку по заданной конфигурации

setup.exe /configure configuration.xml

Бинго! Поставили только то, что нужно.

Прошлая дата в date для разных шеллов

В разного рода скриптах иногда нужно получить значение предыдущих дат, на несколько дней назад. В стандартном линуксовом шелле bash это делается

$ date -u "+%F" -d "-3 day"

Однако, вышеуказанный способ не обязательно работает для других интерпретаторов. Для BSD стандартный шелл обычно csh, там аналогичный результат возвращается командой

$ date -v-2d "+%F"

Резервирование UEFI в Linux

В большинстве случаев на серверные системы Linux ставится на RAID, железный или программный. В простом случае программный рейд создаётся при помощи mdadm, в форме зеркала. Корень и разделы системные и данных легко ставятся на получившиеся /dev/mdX-разделы и такое решение отлично защищает от потери данных в случае аппаратной неисправности жесткого диска. Однако, в стандартной установке загрузчик ставится только на один жёсткий диск и в случае его поломки система не загрузится. Поставим задачу зарезервировать ещё и загрузку, т.е. сделать систему загружаемой с любого из дисков зеркала.

Будем рассматривать наиболее простую конфигурацию и разбиение носителей — 2 NVMe-тома, на которых всего по 2 раздела: для UEFI и для корня системы. Например:

# fdisk /dev/nvme0n1
...
Device          Start       End   Sectors  Size Type
/dev/nvme0n1p1   2048    526335    524288  256M EFI System
/dev/nvme0n1p2 526336 879097934 878571599  419G Linux RAID

Имеем первый раздел для EFI и второй под корень системы. Корень уже в mdadm массиве уровня 1, с ним все уже в порядке. Второй такой же носитель /dev/nvme1n1 имеет в точности такую же разбивку.

После установки получим efi-раздел, монтируемый в /boot/efi и параметры загрузки EFI вроде

# efibootmgr -v
BootCurrent: 0000
Timeout: 1 seconds
BootOrder: 0000,0002,0006,0005
Boot0000* debian        HD(1,800,80000,0496eff8-477c-4335-ada1-ce9200ddff6e)File(\EFI\debian\grubx64.efi)
Boot0002* UEFI: Built-in EFI Shell      Vendor(5023b95c-db26-429b-a648-bd47664c8012,)..BO
Boot0005* UEFI: Intel(R) I350 Gigabit Network Connection        ACPI(a0341d0,0)PCI(3,3)PCI(0,0)MAC(MAC(0cc47ada7688,1)..BO
Boot0006* UEFI: IP4 Intel(R) I350 Gigabit Network Connection    ACPI(a0341d0,0)PCI(3,3)PCI(0,0)MAC(MAC(0cc47ada7688,1)..BO
Boot0007* UEFI: Intel(R) I350 Gigabit Network Connection        ACPI(a0341d0,0)PCI(3,3)PCI(0,1)MAC(MAC(0cc47ada7689,1)..BO
Boot0008* UEFI: IP4 Intel(R) I350 Gigabit Network Connection    ACPI(a0341d0,0)PCI(3,3)PCI(0,1)MAC(MAC(0cc47ada7689,1)..BO

Раздел /dev/nvme0n1p1 непустой и содержит загрузчик. Аналогичный раздел со второго носителя /dev/nvme1n1p1 пустой. Запишем загрузчик в него и добавим его в последовательность загрузки. В случае BIOS срабатывал штатный grub-install на второй диск. Здесь аналогичный способ перепишет строчку в последовательности загрузки efiboot выше и по сути переключит загрузку на второй диск. Поступим иначе, а именно наново сделаем загрузку на второй диск, её сохраним, и затем вернём загрузку с первого.

Для начала подменим уже смонтированный раздел /dev/nvme0n1p1 аналогичным со второго диска

umount /boot/efi
mount -o umask=0077 /dev/nvme1n1p1 /boot/efi

и убедимся, что смонтировался именно он. Если этот раздел не отформатирован при загрузке сделаем это сейчас

mkfs.vfat -F32 /dev/nvme1n1p1

FAT32 может не быть в системе изначально, он доустанавливается из dosfstools. Раздел должен быть пустым.

Далее стандартными средствами, по мануалу дебиана прописываем загрузчик:

apt-get install --reinstall grub-efi
grub-install /dev/nvme1n1
update-grub

В результате получаем загрузчик в /boot/efi (смонтированный на /dev/nvme1n1p1) и строчку в последовательности UEFI-загрузки

# efibootmgr -v
BootCurrent: 0000
Timeout: 1 seconds
BootOrder: 0000,0002,0006,0005
Boot0000* debian       HD(1,800,80000,37194fa6-dca2-491e-a0cf-a7fded36e2c5)File(\EFI\debian\grubx64.efi)
Boot0002* UEFI: Built-in EFI Shell      Vendor(5023b95c-db26-429b-a648-bd47664c8012,)..BO
Boot0005* UEFI: Intel(R) I350 Gigabit Network Connection        ACPI(a0341d0,0)PCI(3,3)PCI(0,0)MAC(MAC(0cc47ada7688,1)..BO
Boot0006* UEFI: IP4 Intel(R) I350 Gigabit Network Connection    ACPI(a0341d0,0)PCI(3,3)PCI(0,0)MAC(MAC(0cc47ada7688,1)..BO
Boot0007* UEFI: Intel(R) I350 Gigabit Network Connection        ACPI(a0341d0,0)PCI(3,3)PCI(0,1)MAC(MAC(0cc47ada7689,1)..BO
Boot0008* UEFI: IP4 Intel(R) I350 Gigabit Network Connection    ACPI(a0341d0,0)PCI(3,3)PCI(0,1)MAC(MAC(0cc47ada7689,1)..BO

Посмотрим таблицу идентификаторов UUID

# blkid
/dev/nvme0n1p1: UUID="AC77-0809" TYPE="vfat" PARTUUID="0496eff8-477c-4335-ada1-ce9200ddff6e"
/dev/nvme0n1p2: UUID="9643fce5-dcfb-1ff3-d03d-14004857da61" UUID_SUB="f5c3d323-29ec-3079-0e58-3259275e26db" LABEL="s00:0" TYPE="linux_raid_member" PARTUUID="d37e4df1-07ef-467e-acf8-ab98bbb60f87"
/dev/nvme1n1p1: UUID="4072-D808" TYPE="vfat" PARTUUID="37194fa6-dca2-491e-a0cf-a7fded36e2c5"
/dev/nvme1n1p2: UUID="9643fce5-dcfb-1ff3-d03d-14004857da61" UUID_SUB="f5e0f678-9b1d-3111-df00-74096ddf7e6d" LABEL="s00:0" TYPE="linux_raid_member" PARTUUID="660ba68e-7e25-4287-a646-3f555b510533"
/dev/md0: UUID="ce3f9f38-e7d9-4c89-ae36-2127a71670e0" TYPE="ext4"
/dev/nvme0n1: PTUUID="86a68d04-a4d9-4296-8a1a-48d02b7171fb" PTTYPE="gpt"
/dev/nvme1n1: PTUUID="1bc21b63-6011-42e9-80ab-1fd120b69907" PTTYPE="gpt"

и убедимся, что в последовательности загрузки стоит идентификатор именно второго диска. Но оригинальная строчка с загрузчиком первого диска перезаписана. Поэтому, вручную добавим строчку для второго диска под другим номером и под другим названием аналогично существующей:

efibootmgr -c -d /dev/nvme1n1 -p 1 -L "debian1" -l "\EFI\debian\grubx64.efi"

Проверяем результат

# efibootmgr -v
BootCurrent: 0000
Timeout: 1 seconds
BootOrder: 0000,0002,0006,0005
Boot0000* debian        HD(1,800,80000,37194fa6-dca2-491e-a0cf-a7fded36e2c5)File(\EFI\debian\grubx64.efi)
Boot0001* debian1       HD(1,800,80000,37194fa6-dca2-491e-a0cf-a7fded36e2c5)File(\EFI\debian\grubx64.efi)
Boot0002* UEFI: Built-in EFI Shell      Vendor(5023b95c-db26-429b-a648-bd47664c8012,)..BO
Boot0005* UEFI: Intel(R) I350 Gigabit Network Connection        ACPI(a0341d0,0)PCI(3,3)PCI(0,0)MAC(MAC(0cc47ada7688,1)..BO
Boot0006* UEFI: IP4 Intel(R) I350 Gigabit Network Connection    ACPI(a0341d0,0)PCI(3,3)PCI(0,0)MAC(MAC(0cc47ada7688,1)..BO
Boot0007* UEFI: Intel(R) I350 Gigabit Network Connection        ACPI(a0341d0,0)PCI(3,3)PCI(0,1)MAC(MAC(0cc47ada7689,1)..BO
Boot0008* UEFI: IP4 Intel(R) I350 Gigabit Network Connection    ACPI(a0341d0,0)PCI(3,3)PCI(0,1)MAC(MAC(0cc47ada7689,1)..BO

И меняем порядок загрузки на необходимый

# efibootmgr -o 0000,0001,0002

Вторая часть — это вернуть обратно первый загрузчик. Перемонтируем обратно раздел с ним на оригинальный с первого диска

umount /boot/efi
mount /boot/efi

Убеждаемся, что смонтировался именно он, и стандартными средствами записываем загрузчик

apt-get install --reinstall grub-efi
grub-install /dev/nvme1n1
update-grub

Аналогичное можно было сделать и с помощью efibootmgr, как это делали для второго раздела.

В любом способе в конечном варианте загрузки должны видеть примерно следующую последовательность UEFI

# efibootmgr -v
BootCurrent: 0000
Timeout: 1 seconds
BootOrder: 0000,0001,0002
Boot0000* debian        HD(1,800,80000,0496eff8-477c-4335-ada1-ce9200ddff6e)File(\EFI\debian\grubx64.efi)
Boot0001* debian1       HD(1,800,80000,37194fa6-dca2-491e-a0cf-a7fded36e2c5)File(\EFI\debian\grubx64.efi)
Boot0002* UEFI: Built-in EFI Shell      Vendor(5023b95c-db26-429b-a648-bd47664c8012,)..BO
Boot0005* UEFI: Intel(R) I350 Gigabit Network Connection        ACPI(a0341d0,0)PCI(3,3)PCI(0,0)MAC(MAC(0cc47ada7688,1)..BO
Boot0006* UEFI: IP4 Intel(R) I350 Gigabit Network Connection    ACPI(a0341d0,0)PCI(3,3)PCI(0,0)MAC(MAC(0cc47ada7688,1)..BO
Boot0007* UEFI: Intel(R) I350 Gigabit Network Connection        ACPI(a0341d0,0)PCI(3,3)PCI(0,1)MAC(MAC(0cc47ada7689,1)..BO
Boot0008* UEFI: IP4 Intel(R) I350 Gigabit Network Connection    ACPI(a0341d0,0)PCI(3,3)PCI(0,1)MAC(MAC(0cc47ada7689,1)..BO

Таким образом загрузка будет происходить с любого из дисков, даже если один из них выйдет из строя.

Несколько интерфейсов в LXC

Бывает, что в создаваемых виртуальных машинах LXC нужно доступ к разным подсетям посредством нескольких интерфейсов. А изначальный конфиг виртуалки содержит настройки одного интерфейса. Дополнительный интерфейс добавляется в том же конфиге по аналогии с первым, например:

lxc.network.type = veth
lxc.network.name = eth0
lxc.network.link = lxcbr0
lxc.network.ipv4 = 12.34.56.78
lxc.network.flags = up

lxc.network.type = veth
lxc.network.link = br1
lxc.network.ipv4 = 10.0.3.5/24
lxc.network.name = eth1
lxc.network.flags = up

Уменьшение размера образов qemu

Linux в связке с qemu является отличной платформой для виртуализации, в том числе Windows-систем. Ключевой особенностью виртуализации в случае «инородных» систем является использование под эту систему файла-образа или отдельного блочного устройства. И то и другое обычно занимает достаточно много места. Попробуем минимизировать используемое место в этом случае.

Среди поддерживаемых qemu форматов образов есть как обычные бинарные образы (img), так и сжатые и несжатые qcow/qcow2. Последний формат в сжатом варианте показывает очень хорошие результаты по использованию места: его образы занимают мало места и при этом размер «внутреннего» жесткого диска в виртуальной системе может быть очень большим. Использоавать этот формат можно изначально, при создании виртуальной машины с помощью qemu-img, или конвертацией образа другого формата в qcow2

qemu-img convert -O qcow2 -c win10.img win10.qcow2

Сжатие в формате qcow2 используется в режиме «только для чтения», т.е. если что-то из образа переписывается, то перезапись происходит уже в несжатом формате. Получается, что сжатой будет статичная часть системы и данных в образе, которые в зависимости от задачи вируталки могут занимать основную часть данных. Для таких машин это формат будет наиболее подходящим.
Руководство qemu-img также предупреждает, что при использовании сжатия несколько уменьшается производительность. Однако, субъективно разницы между несжатым и сжатым форматом мне заметить не удалось.

При конвертации в qcow2 и сжатии следует заранее позаботиться о «чистоте» образа: занулить всё неиспользуемое на нём пространство. В Руководстве Proxmox подробно описываются способы, которыми это можно сделать. Наиболее короткий — очистить диск с помощью майкросовтовской утилиты sdelete, например:

sdelete -z C:

В последней версии утилиты 2.0 есть баг — она зависает на 100%. В этом случае имеет смысл использовать более старую версию 1.6. Есть также вариант использовать графическую Eraser, но это обычно более длинный путь.

В ходе использования образ понемного увеличивается в размере. После длительного использования образ можно сократить в размере тем же самым способом: занулив свободное места и переконвертацией его в qemu-img:

qemu-img convert -O qcow2 -c win9.qcow2_backup win9.qcow2

Естественно, как и перед очисткой образа, так и его пережатием крайне желательно сделать бэкап.

В результате перечисленных выше нехитрых операций можно уменьшить размер образов на порядок, т.е. в 10 раз и более.

Быстрая установка VNC на Debian Jessie

Иногда на Linux бывает полезна графическая оболочка, причём в режиме удалённого доступа. Подключение к графике удалённо типично производят с помощью VNC. Рассмотрим простую настройку VNC-сервера на Debian Jessie для эпизодических графических сессий.

В качестве сервера будем использовать tightvncserver, в качестве рабочего стола XFCE. Для начала ставим необходимый софт

apt-get install xfce4 xfce4-goodies gnome-icon-theme tightvncserver

Стартуем VNC

$ vncserver

при первом старте (в случае пустой директории с конфигурацией ~/.vnc) он запросит пароль на соединение и создаст конфигурацию. В конце скрипта ~/.vnc/xstartup добавляем запуск XFCE4

xfce4-session &

Завершить VNC-сервер можно

$ vncserver -kill :1

и это имеет смысл сделать для последующей настройки.

Проверяем, что VNC-сервер запускается и корректно работает. Для этого его запускаем

$ vncserver -geometry 1024x600

проверяем, что соответствующий процесс действительно слушает 5901 порт

netstat -tpan | grep :59

и подключаемся к нему. В случае успеха мы увидим рабочий стол созданной сессии.

Вышеперечисленные операции старта-остановки целесообразно несколько автоматизировать. Для этого создаем скрипт по аналогу демоновских скриптов из /etc/init.d/ с содержанием вроде:

#!/bin/bash
PATH="$PATH:/usr/bin/"
DISPLAY="1"
DEPTH="16"
GEOMETRY="1280x1024"
#GEOMETRY="1024x768"
OPTIONS="-depth ${DEPTH} -geometry ${GEOMETRY} :${DISPLAY}"

case "$1" in
start)
/usr/bin/vncserver ${OPTIONS}
;;

stop)
/usr/bin/vncserver -kill :${DISPLAY}
;;

restart)
$0 stop
$0 start
;;
esac
exit 0

и помещаем его в директорию локальных скриптов /usr/local/bin/mvnc.

Тогда VNC-сервером можно управлять командами, полностью по аналогии с демонами:

mvnc start
mvnc stop
mvnc restart

Делать это можно из под простого пользователя, что в случае простой конфигурации вполне достаточно. При желании можно сделать более сложный init.d-скрипт и поместить его в /etc/init.d/ в автостарт, но это не всегда нужно, если VNC используется эпизодически.

SSH без дисконнекта

При длительной работе в терминале по SSH, особенно с длительными перерывами, очень удобно, чтобы подключение сохранялось всё это время. Если не отсылать и получать данные в открытом подключении, то через некоторое время сессия разрывается по таймауту, что обычно неудобно. Исправим это.

В протоколе реализована возможность сохранения сессии, TCPKeepAlive, клиент или сервер посылает «пустой» пакет, тем самым оживляет сессию и держит её открытой. Фича реализована как на клиенте, так и на сервере. На клиенте она включается в пользовательском конфиге ssh ~/.ssh/config

ServerAliveInterval 90

Клиент будет каждые 90 секунд отправлять пакет серверу и тем самым поддерживать соединение.

Можно настроить периодическое оживление и в общем случае, для всех клиентов сервера. В конфигурации демона /etc/ssh/sshd_config добавляем или правим

ClientAliveInterval 90
ClientAliveCountMax 960

В этих настройках сервер будет отправлять пакет каждые 90 секунд и максимум делать это 960 раз. В результате соединение продержится до суток (90*960 = 86400 = 24h).

Samba >=4.2 и Windows XP

С выходом самбы 4.2 поменялись настройки безопасности, которые идут по умолчанию из коробки. В частности, в дефолтной версии отключена поддержка старого протокола аутентификации для защиты от MTM-атак (человек по середине).
В результате этого старые ОС (Windows XP и похожего срока древности) не могут аутентифицироваться и работать с windows-шарами под samba. Тем не менее, кое-где ещё используются такие динозавры, поэтому нужно включить в самбе старый протокол и не бояться MTM.

Вот что пишут в apt-listchanges к пакету:

Suggested further improvements after patching:

It is recommended that administrators set these additional options,
if compatible with their network environment:

server signing = mandatory
ntlm auth = no

Without «server signing = mandatory», Man in the Middle attacks
are still possible against our file server and
classic/NT4-like/Samba3 Domain controller. (It is now enforced on
Samba’s AD DC.) Note that this has heavy impact on the file server
performance, so you need to decide between performance and
security. These Man in the Middle attacks for smb file servers are
well known for decades.

Without «ntlm auth = no», there may still be clients not using
NTLMv2, and these observed passwords may be brute-forced easily using
cloud-computing resources or rainbow tables.

Из некоторого анализа новых фич и изменённых настроек становится ясно, что включается поддержка нужного протокола одной строчкой global-секции:

        ntlm auth = no

которая позволяет аутентифицироваться и работать старым ОС, при этом понижая общую безопасность.

Подключение bind9 к мониторингу munin

Для отладки да и просто для статистики полезно мониторить какие запросы идут к named-серверу, какие из них выполняются корректно и какие некорректные. Демон bind позволяет настроить гибкое логирование запросов, затем эти логи можно анализировать сторонней утилитой. В качестве такой утилиты удобно использовать систему мониторинга munin с bind-плагинами «из коробки».

Первое, что сделаем — включим нужные плагины. Их в директории с готовыми плагинами два, оба и подключим

cd /etc/munin/plugins
ln -s /usr/share/munin/plugins/bind9
ln -s /usr/share/munin/plugins/bind9_rndc

Эти плагины — перловские скрипты. Из их исходного текста можно увидеть, что первый из них (bind9) парсит стандартный лог неймсервера /var/log/bind9/query.log, второй (bind9_rndc) — парсит данные rndc из /var/run/named.stats и выдаёт расширенную статистику по запросам к DNS-серверу. В большинстве задач достаточно будет и общего плагина, однако, сконфигурируем их оба.

bind9

Конфигурируем параметры запуска скрипта мониторинга. Соответственно, общего плагина в файле /etc/plugin-conf.d/bind9:

[bind9]
user bind
env.logfile /var/log/named/query.log

Стандартная директория для логов bind /var/log/named, а мунин их читает из /var/log/bind9. Поэтому, явно указываем в конфиге путь к логу (как сделано выше). Как альтернатива, чтобы вносить меньше правок в конфигурацию, можно сделать симлинк:

cd /var/log
ln -s named bind9

Далее, настроим сбор логов от неймсервера в лог. Для этого создаем файл (например /etc/bind/logging.conf) с указанием данных, которые нужно писать в лог. Не будем мелочиться и настроим наиболее полное логирование, причем разных каналов в разные файлы.

logging {
	channel default_file {
		file "/var/log/named/default.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel general_file {
		file "/var/log/named/general.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel database_file {
		file "/var/log/named/database.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel security_file {
		file "/var/log/named/security.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel config_file {
		file "/var/log/named/config.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel resolver_file {
		file "/var/log/named/resolver.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel xfer-in_file {
		file "/var/log/named/xfer-in.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel xfer-out_file {
		file "/var/log/named/xfer-out.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel notify_file {
		file "/var/log/named/notify.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel client_file {
		file "/var/log/named/client.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel unmatched_file {
		file "/var/log/named/unmatched.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel queries_file {
		file "/var/log/named/query.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel network_file {
		file "/var/log/named/network.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel update_file {
		file "/var/log/named/update.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel dispatch_file {
		file "/var/log/named/dispatch.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel dnssec_file {
		file "/var/log/named/dnssec.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};
	channel lame-servers_file {
		file "/var/log/named/lame-servers.log" versions 5 size 10m;
		severity dynamic;
		print-category yes;
		print-severity yes;
		print-time yes;
	};

	category default { default_file; };
	category general { general_file; };
	category database { database_file; };
	category security { security_file; };
	category config { config_file; };
	category resolver { resolver_file; };
	category xfer-in { xfer-in_file; };
	category xfer-out { xfer-out_file; };
	category notify { notify_file; };
	category client { client_file; };
	category unmatched { unmatched_file; };
	category queries { queries_file; };
	category network { network_file; };
	category update { update_file; };
	category dispatch { dispatch_file; };
	category dnssec { dnssec_file; };
	category lame-servers { lame-servers_file; };
};

Для munin потребуется только лог запросов query.log, остальное — в отладочных целях и смело можно вычеркнуть.
Включаем этот файл в конфиге бинда

include "/etc/bind/logging.conf";

рестартуем демон и проверяем, что файлы лога создались и пишутся корректно. Заранее создаем директорию под логи и выставляем на неё нужные права.

Далее, нужно убедиться, что лог читаем для парсера плагина, что делается штатной муниновской командой

munin-run bind9

В случае корректной настройки тест вернёт количество запросов разного типа. Или не вернёт — тогда нужно искать ошибку в конфигурации. Типичная ошибка происходит с правами доступа, поэтому или выставляем доступные права для /var/named/* или настраиваем запуск плагина от рута.

bind9_rndc

Включаем сам плагин для сбора статистики rndc в /etc/plugin-conf.d/bind9_rndc и настраиваем его параметры:

[bind9_rndc]
user bind
env.querystats /var/cache/bind/named.stats

Путь для файла статистики намеренно указан нестандартный, поскольку apparmor в дистрибутивах Debian/Ubuntu ограничивает запись в стандартную директорию /var/run/named. Поэтому указываем файл в директории для кеша, где нет явных ограничений на запись.

Теперь включим расширенную статистику rndc со стороны bind. Включаем в конфигурации (обычно /etc/bind9/named.conf.options) строчку:

statistics-file "/var/cache/bind/named.stats";

и рестартуем bind9.

Аналогично вышеуказанному плагину проверяем, что плагин работает корректно

munin-run bind9_rndc

По окончании, чтобы мунин подхватил новые настройки, его демон нужно перезапустить. Перезапускаем мунин

/etc/init.d/munin-node restart

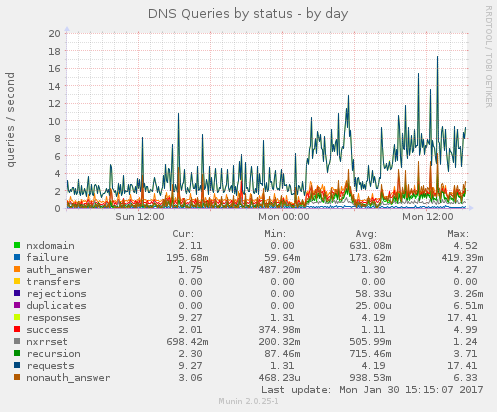
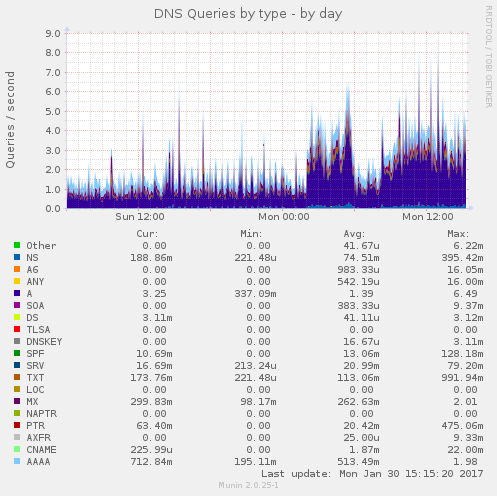
и проверяем, что логи корректно парсятся и в отчётах мунина присутствует статистика по DNS-запросам. В хорошем случае получаем картинки такого вида

Как в MS SQL Server уменьшить размер логов

В процессе работы с базами данных MS SQL с полным логом транзаций через некоторое время этот лог разрастается до внушительных размеров и начинает занимать места больше, чем сама база данных. Есть несколько путей очистки этого лога.

1. Короткий и скорее нерекомендуемый путь

backup log [dbname] TO DISK='NUL'
go
DBCC SHRINKDATABASE ([dbname], 10, TRUNCATEONLY)
go

2. Более длинный, но скорее более надёжный способ (из обсуждения)

USE dbname;
GO
-- Truncate the log by changing the database recovery model to SIMPLE.
ALTER DATABASE dbname
SET RECOVERY SIMPLE;
GO
-- Shrink the truncated log file to 1 MB.
DBCC SHRINKFILE (2, 1);  -- here 2 is the file ID for trasaction log file,you can also mention the log file name (dbname_log)
GO
-- Reset the database recovery model.
ALTER DATABASE dbname
SET RECOVERY FULL;
GO

PS: Естественно, экспериментировать с БД и обрезать логи необходимо после полного бэкапа БД заранее.

Windows GodMode

В Windows версий выше 6.0 есть отличный способ получить доступ к огромному списку настроек из одного окна. Для этого создаем папку с именем

GodMode.{ED7BA470-8E54-465E-825C-99712043E01C}

Часть названия до точки может быть любой, а после точки — это GUID соответствующей фичи. После создания «папки» у неё меняется иконка и она ведёт в очень удобную управлялку.

Причём этот способ не является каким-то волшебством, его механизм описан очень давно. Похожим образом можно создать «ярлык» для многих других управлялок, что подробно описано в справке Майкрософта. Интересно, что в этой справке нет GUID для вышеупомянутой панели, несмотря на то, что она даже успела засветиться в Википедии.