Разный вывод di и df в Linux

Интересные дела…

user@server:~$ di
Filesystem         Mount               Size     Used    Avail %Used  fs Type
/dev/md0           /                   1.9G     0.4G     1.4G   26%  ext4   
udev               /dev                5.9G     0.0G     5.9G    0%  tmpfs  
tmpfs              /dev/shm            5.9G     0.0G     5.9G    0%  tmpfs  
tmpfs              /lib/init/rw        5.9G     0.0G     5.9G    0%  tmpfs  
/dev/shm           /run/shm            5.9G     0.0G     5.9G    0%  none   
/dev/md1           /usr                9.4G     0.8G     8.1G   14%  ext4   
/dev/md3           /var                1.8T     0.1T     1.6T   11%  ext4   

user@server:~$ df 
Filesystem      1K-blocks      Used  Available Use% Mounted on
/dev/md0          1966404    416816    1449700  23% /
tmpfs             6163396         0    6163396   0% /lib/init/rw
udev              6157924       228    6157696   1% /dev
tmpfs             6163396         4    6163392   1% /dev/shm
/dev/md1          9842136    833200    8508972   9% /usr
/dev/md3       1899242804 108050616 1694716184   6% /var
phpmyadmin за SSL-фронтендом nginx

Администрировать БД MySQL часто бывает удобно с помощью phpmyadmin. Естественно, пользоваться им необходимо безопасно, т.е. через https.

Простой вариант решения заключается в указании явного URL для пхпмайадмина в его конфиге:

$cfg['PmaAbsoluteUri'] = 'https://admin.example.com/pma';

Это полностью рабочий и безопасный для других сайтов вариант, но требует правки конфига phpmyadmin.

Альтернативный вариант — передавать порт, по которому идет соединение на nginx front-end от пользователя. Для этого в стандартных настройках прокси для энжикса меняем

proxy_set_header Host $host;

на

proxy_set_header Host $host:$server_port;

Однако, последний способ выдает некоторые глюки на другом коде, который исполняется на том же домене.

Восстановление RAID 10 массива

Поломался однажды RAID10 массив. Как обычно, все произошло внезапно: однажды перезапустили сервер, и получили «(что-то там) … not found». С поврежденным (degraded) массивом сервер стартовать отказался. Массив работал на полусофтовом-полухардварном псевдоконтроллере материнской платы Intel. Физически все жесткие диски оказались здоровыми, хотя для нижеописанного это не критично.

Далее следует описание восстановления информации с массива из серии «с помощью швейцарского перочинного ножа», т.е. без применения изощрённых средств восстановления. Если конкретно, понадобится компьютер с любым *nix и интерпретатором python3. Можно, конечно, воспользоваться программами вроде R-Studio, однако, по-моему это слишком простая задача для них.

Итак, делаем следующее. Открываем в бинарном редакторе все 3 диска и выбираем из них пару striped дисков, т.е. на которых чередующимися блоками составляют весь массив (как RAID 0). Делаем образы обоих жестких дисков в файлы с помощью замечательной утилиты dd по типу

dd if=/dev/sdX of=/tmp/vY.hdd bs=32M

В итоге получаем два больших файла v0.hdd, v1.hdd. С самими HDD далее не работаем.

Снова открываем с помощью бинарного редактора какой-нибудь из образов и определяем размер stripe-элемента (chunk size). Сделать это не сложно даже «невооружённым взглядом»: ищется несколько этих кусков с чёткими границами. Легче всего это сделать на файле с вразумительным содержимом, или даже на любом — если свободное место (почти) заполнено нулями. В нашем случае размер stripe оказался 64K. При этом на одном из образов в начальном секторе сразу обнаружился MBR, а во втором нечто совсем не похожее на MBR. Так стал понятен порядок stripe от разных дисков.

Осталось почти ничего: брать поочередно chunks куски с разных дисков, складывать их последовательно и получить образ всего массива. Пишем для этого элементарный скрипт на питоне:

#!/usr/bin/python3
"""RAID0 recovery utility."""

dev0 = '/tmp/v1.hdd'
dev1 = '/tmp/v0.hdd'

DEV_OUT = '/tmp/out.hdd'

# stripe 64k
STRIPE = 64 * 1024
	
MAX_COUNT = 500 * 2**29 // STRIPE MAX COUNT

if __name__ == '__main__':
	f0 = open(dev0, 'rb')
	f1 = open(dev1, 'rb')

	f_out = open(DEV_OUT, 'wb')

	offset = 0
	while offset < MAX_COUNT:
		d0 = f0.read(STRIPE)
		d1 = f1.read(STRIPE)

		if d0 and d1:
			f_out.write(d0)
			f_out.write(d1)

			offset += 1
		else:
			print("One of input files are finished. Read: {0} blocks.".format(offset))
			break

	f0.close()
	f1.close()
	f_out.close()

Запускаем скрипт, оставляем его на ~10 минут и на выходе получаем полный образ диска. Разделы из него успешно монтируются самостоятельно или могут быть (всем образом) записаны на физический HDD. Так, совсем несложно и без дорогого софта, можно восстановить запоротый RAID10-массив.

LXC контейнеры в Debian jessie

LXC представляет собой набор утилит для управления виртуализацией на уровне операционной системы. Технология основана на механизме cgroups, которая позволяет создавать несколько Linux-окружений с собственным пространством процессов и сетевым стеком. Все контейнеры работают на одном ядре вместе с основной машиной, что делает виртуализацию этого типа очень эффективной. По этой причине виртуализация такого типа — отличный выбор для различных применений, где не требуется устанавливать дополнительные модули к ядру и подобная специфика.

Почти всю полезную информацию можно найти в дебиановском источнике. Ниже — наиболее короткий howto, как быстро настроить lxc-виртуализацию под Debian Linux.

Настройка хост-машины

Начинаем как обычно с установки необходимого софта

apt-get install lxc bridge-utils libvirt-bin debootstrap

Контейнеры будем создавать в стандартной директории /var/lib/lxc. Для удобства сделаем симлинк в корне файловой системы на эту директорию:

ln -s /var/lib/lxc

Настроим сеть. Для этого доустанавливается пакет bridge-utils, типовой конфиг сети (/etc/network/interfaces) будет следующим

auto lo
iface lo inet loopback

auto br0
iface br0 inet static
	address 123.123.123.3
	netmask 255.255.255.248
	gateway 123.123.123.1
	bridge_ports eth0
	bridge_fd 0
	bridge_maxwait 0
	bridge_stp off
	dns-nameservers 8.8.8.8 8.8.4.4

Проверяем, всё ли в порядке с установкой

lxc-checkconfig

и если все нормально, то ставим туда первый контейнер

lxc-create -n myvm -t debian

В результате получаем виртуальную машину и root-пароль к ней. Контейнер будет из stable-дистрибутива (Wheezy), однако его можно дообновить до testing или изначально ставить testing.

Настройка виртуальной машины

Конфиг виртуальной машины находится в /lxc/myvm/config. Доводим его до вменяемого состояния, например такого

lxc.network.type = veth
lxc.rootfs = /var/lib/lxc/myvm/rootfs

# Common configuration
lxc.include = /usr/share/lxc/config/debian.common.conf

# Container specific configuration
lxc.mount = /var/lib/lxc/myvm/fstab
lxc.utsname = myvm
lxc.arch = amd64


lxc.network.flags = up
lxc.network.link = br0

lxc.network.hwaddr = 00:25:90:01:5e:22

lxc.start.auto = 1

Последний параметр отвечает за автозагрузку при запуске основной машины.

Перед запуском виртуалки также меняем сетевые настройки в /etc/network/interfaces.

В новой системе только минимальный набор софта, который не включает в себя некоторые широкоизвестные и часто применяемые утилиты. Например, не получится сразу выполнить ping, поскольку соответствующего ему пакета нет в системе. Доустанавливаем необходимый софт:

apt-get install apt-utils iputils-ping cron rsyslog iptables

Иногда будем получать ругань вроде

perl: warning: Setting locale failed.
perl: warning: Please check that your locale settings:
        LANGUAGE = (unset),
        LC_ALL = (unset),
        LC_CTYPE = "ru_RU.UTF-8",
        LC_COLLATE = "ru_RU.UTF-8",
        LC_MESSAGES = "C",
        LC_NUMERIC = "POSIX",
        LANG = (unset)
    are supported and installed on your system.
perl: warning: Falling back to the standard locale ("C").
locale: Cannot set LC_CTYPE to default locale: No such file or directory
locale: Cannot set LC_ALL to default locale: No such file or directory

Поэтому сразу конфигурируем локаль

dpkg-reconfigure locales

Стандартного почтового агента (MTA) в системе тоже нет, поэтому ставим его и настраиваем:

apt-get install exim4
dpkg-reconfigure exim4-config

Полезные команды для управления

Запустить и погасить виртуальную машину используются

lxc-start -n myvm -d
lxc-stop -n myvm

Параметр -d в случае старта означает запуск в режиме демона. Если его не указать, то getty захватит текущую консоль (что бывает полезно, если не удаётся подключиться по SSH).

Получить краткую информацию о статусе машины можно с помощью

lxc-info -n myvm

Заключение

Вышеприведенная конфигурация — очень быстрый способ поставить виртуальную машину, например для целей тестирования ПО. Если требуется даже базовая безопасность, необходимо много чего доработать.

PS

Статья устарела. Более качественный способ приведён в дебиановском мануале. И, что важно, постоянно обновляется.

Debian hostname

Правильно настроенный хост должен возвращать следующие имена hostname:

  • короткое имя по hostname
  • FQDN по hostname -f
  • доменное имя по hostname -d

Ключи естественным образом взяты из мануала и результат этих команд — простой тест на правильную конфигурацию хостнейма. От корректности настройки зависит работа многих приложений на сервере, веба, почты и т.п.

Иногда на принимаемых серверах hostname настроен некорректно. Правится ситуация несложным образом:

  • Проверяем, что в /etc/hostname прописано короткое имя. Если нет, то прописываем.
  • Проверяем, что в /etc/hosts первым доменом на ip-адрес сервера прописан FQDN и если нет, то прописываем.
    1.2.3.4 somehost.prod.example.com somehost somehost.prod
    

После изменений перегружаем сервер для проверки, что весь софт правильно работает с загрузки сервера.

Дополнение:
Неправильный hosts, а точнее не-FQDN на первом месте после ip-адреса сервера приводит к ошибке apache2:

AH00558: apache2: Could not reliably determine the server's fully qualified domain name, using XXX.XXX.XXX.XXX. Set the 'ServerName' directive globally to suppress this message                                                                                                 

Установка sphinx-плагина для memcached в Debian

Многие плагины к сфинксу в дебиане можно найти и подключить с помощью

munin-node-configure --suggest
munin-node-configure --shell

Однако, есть много стоковых плагинов в /urs/share/munin/plugins/, которые не предлагаются и не включаются таким способом. В частности, плагин к memcached подключается вручную. Ставится он коротко следующим образом.

Плагин требует перловскую библиотеку Cache::Memcached, если её нет в системе — ставим:

apt-get install libcache-memcached-perl

Далее вручную идем в директорию с конфигами и подключаем плагин:

cd /etc/munin/plugins
ln -s /usr/share/munin/plugins/memcached_ memcached_rates
ln -s /usr/share/munin/plugins/memcached_ memcached_bytes
ln -s /usr/share/munin/plugins/memcached_ memcached_counters

Что означают все показатели и как работает плагин можно посмотреть в самом perl-скрипте /usr/share/munin/plugins/memcached_.

Далее запускаем получившиеся симлинки и проверяем, что плагин работает. По окончании рестартуем munin-node:

Ограниченный SFTP-доступ на сервер

Часто возникает задача дать доступ на сервер в определенную директорию по протоколу sftp, чтобы при этом не было доступа в весь корень файловой системы. Т.е. используя технику chroot. Делается это следующим образом.

Сначала создается пользователь в системе. Обычно по sftp заходят для правки контента и группа пользователя назначается общей для этого рода пользователей (например, www-data). Всё это делается опциями к adduser или useradd.

Далее в /etc/ssh/sshd_config созданному пользователю newuser добавляется кусок конфига, который определяет параметры входа и chroot:

Match User newuser
	ChrootDirectory %h
	ForceCommand internal-sftp
	AllowTcpForwarding no
	X11Forwarding no

После изменения конфига, естественно, нужно рестартануть sshd.

На этом все не заканчивается. Вот что гласит мануал sshd_config:

ChrootDirectory
Specifies the pathname of a directory to chroot(2) to after authentication. All components of the pathname must be root-owned directories that are not writable by any other user or group. After the chroot, sshd(8) changes the working directory to the user’s home directory.
…

Из соображений безопасности, чтобы работал chroot, директория пользователя должна быть от пользователя root (при этом группа может быть не рутовой). Выполняем это требование, voila и всё работает.

Также для безопасности обычно имеет смысл отключить шелл пользователя

	usermod newuser -s /bin/false

PS: Это все применимо именно для sftp. К сожалению, для scp это не работает и при попытке подключиться по ssh/scp произойдет ошибка.

Полезные команды для работы с LSI raid массивами

Несколько ранее я уже писал о замене HDD в рейд-массивах контроллеров LSI с помощью оригинальной утилиты MegaCLI. Список полезных команд этой утилиты намного шире, здесь я сохраню наиболее полезные из них.

В командах используются следующие параметры:

  • Адаптер: -aN. На сервере может быть установлено несколько физических RAID-контроллеров, номер нужного указывается параметром -a. Обычно установлен только один контроллер, для этого случая будет стандартный параметр -a0. Значением ALL можно указать сразу все доступные контроллеры.
  • Логический (виртуальный) диск: -Lx. Вместо x идет номер диска (начиная с 0). Также, допустимо значение ALL, выбирающий все доступные диски контроллера.
  • Физический диск: -PhysDrv [E:S]. E (Enclosure) — это номер корзины, S (slot) — номер слота начиная с 0.

Информация о контроллерах, логических и виртуальных дисках

Информация о корзинах (Enclousure) на всех контроллерах:

./MegaCli64 -EncInfo -aALL

Просмотр всех настроек контроллера 0:

./MegaCli64 -AdpAllInfo -a0
./MegaCli64 -ShowSummary -a0
./MegaCli64 -CfgDsply -a0

Получить состояние всех логических дисков:

./MegaCli64 -LDInfo -LALL -aALL

Информация о логических (виртуальных) дисках, т.е. собственно RAID-массивах:

./MegaCli64 -LDInfo -L0 -aALL

Информация о состоянии конкретного физического диска

./MegaCli64 -pdInfo -PhysDrv [4:11] aALL

Статус ребилда

./MegaCli64 -PDRbld -ShowProg -PhysDrv [4:11] -aALL

Логи контроллера

Одна из наиболее полезных комманд, когда ничего вроде не случилось, но что-то работает не так — просмотр логов. Это делается с помощью:

./MegaCli64 -AdpEventLog -GetSinceReboot -f events.log -aALL
./MegaCli64 -AdpEventLog -GetLatest 10 -f t1.log -aALL

Проверка прошивки

./MegaCli64 -PDList -aALL | grep Firmware

Диски горячей замены [hotspare]

Назначение диском горячей замены для определенного массива:

./MegaCli64 -PDHSP -Set -Dedicated -Array0 -PhysDrv[4:2] -a0

Назначить глобальным HotSpare-диском:

./MegaCli64 -PDHSP -Set -PhysDrv[252:2] -a0

Снятие статуса диска горячей замены:

./MegaCli64 -PDHSP  -Rmv -PhysDrv[4:2] -a0

Назначение загрузочного массива

./MegaCli64 -AdpBootDrive -set -L0 -a0

Параметры HDD S.M.A.R.T.

Параметры SMART можно получить с помощью стандартной линуксовой утилиты smartctl, если явно указать контроллер и id диска. Заранее необходимо собрать id исследуемых дисков, это параметр 'Device Id' в списке физических дисков. Можно собрать и все доступные id:

./MegaCli64 -PDList -a0 | grep 'Device Id'

Теперь для искомых дисков можно запрашивать смарт-параметры, например для id=5:

smartctl -d sat+megaraid,5 -a /dev/sdb

locale failed in Debian

При установке в свежей ОС Debian новых пакетов обычно возникает ошибка вроде

perl: warning: Setting locale failed.
perl: warning: Please check that your locale settings:
LANGUAGE = «en_US:en»,
LC_ALL = (unset),
LC_CTYPE = «ru_RU.UTF-8»,
LANG = «en_US.UTF-8»
are supported and installed on your system.
perl: warning: Falling back to the standard locale («C»).

Для исправления нужно подключить локали, хватает русской и английской utf-8. Для этого:

dpkg-reconfigure locales

И там выбираем соответствующие en_US.UTF-8 и ru_RU.UTF-8.

Полезные твики bash

В этой статье наиболее полезные способы быстрой и продуктивной работы с коммандной строкой bash. Предполагается, что читатель уже несколько знаком с коммандной строкой, поэтому совсем тривиальных вещей, вроде использования Tab для автодополнения, здесь нет. В комментарии приветствуются другие полезные «твики» bash.

Алиасы

Листинги

alias ll='ls -l'
alias l='ls -lA'

Часто эти опции уже включены в .bashrc, но закомментированы. В Debian, например, в конфиге это реализовано так

# export LS_OPTIONS='--color=auto'
# eval "`dircolors`"
# alias ls='ls $LS_OPTIONS'
# alias ll='ls $LS_OPTIONS -l'
# alias l='ls $LS_OPTIONS -lA'

Остается раскомментировать нужные строчки. При этом в нагрузку получаем цветовую подсветку директорий.

Часто используемая команда по поиску процесса с определенным именем:

alias pg='ps aux | grep '

Просмотр наибольших файлов/директорий в гигабайтах и мегабайтах соответственно:

alias dug='du -h | grep ^[0-9.]*G | sort -rn'
alias dum='du -h | grep ^[0-9.]*M | sort -rn'

Полезности для скриптов

Иногда бывает полезным поймать сигналы, посылаемые ОС скрипту. Например, при нажатии Ctrl-C.

trap control_c SIGINT
trap control_c SIGTERM

Часто используемые команды

Часто бывает необходимо найти файл, в котором имеется определённая подстрока. Сделать это можно с помощью стандарной утилиты grep командой:

grep -rl

Горячие клавиши bash

  • Ctrl+w — удаляет слово перед курсором в строке,
  • Ctrl+u — удаляет все символы до начала строки,
  • Ctrl+k — удаляет все символы до конца строки,
  • Ctrl+y — вставляет удалённые вышеуказанными сочетаниями символы,
  • Ctrl+r — производит обратный поиск по истории команд,
  • Ctrl+l — очищает экран,
  • Ctrl+z — останавливает исполнение текущей команды (продолжить можно с помощью bg или fg),
  • Ctrl+d — выход из сессии.

История команд bash

В администрировании Linux (да и UNIX тоже) очень удобно пользоваться командами из истории. Содержание истории просматривается с помощью вызова history. Команду из истории можно выполнить по её номеру в списке например так:

history | less
!45

При этом последняя команда вызывается более просто, без указания номера выполнением !!.

Обратный поиск по истории команд вызывается с помощью Ctrl+R, например:

(reverse-i-search)`smart': smartctl -x /dev/sdd | less

Взять аргументы из одной из предыдущих команд можно сочетанием Alt+..

По умолчанию длина истории небольшая и если нет повышенных требований к безопасности её можно несколько увеличить добавлением в .bashrc строки:

export HISTFILESIZE=5000

Длинная история несколько понижает безопасность системы, особенно если в неё попадают всякие «интересные» команды. Поэтому, на критичных системах размер истории большой делать не стоит. Сбросить историю можно

history -c

Избежать добавления команды в историю можно начав её с пробела. Тогда исполненная инструкция в историю не попадает.

grub-install на raid1-массивы

Стандартный установщик Debian при установке на raid1-массив почему-то делает загрузочную запись только на первый носитель (обычно /dev/sda). Если этот носитель через некоторое время сдохнет, то со второго система не загрузится. Для исправления этого бага после установки необходимо сделать что-то вроде grub-install /dev/sda на второй носитель raid-массива.

Уязвимость SSLv3 POODLE

В протоколе SSLv3 обнаружена уязвимость, поэтому все сервисы, завязанные на него следует переконфигурировать. А если точнее, отключить SSLv3 вообще. Ниже кратко как это делается.

nginx

В энжинксе явно разрешаем только хорошие протоколы

ssl_protocols TLSv1 TLSv1.1 TLSv1.2;

apache2

В апаче и ниже — запрещаем.

SSLProtocol all -SSLv3 -SSLv2

dovecot

ssl_protocols = !SSLv3 !SSLv2

postfix

smtpd_tls_mandatory_protocols=!SSLv2, !SSLv3

Тесты SSL уязвимости

Здесь можно проверить на уязвимость свои серверы, а здесь — браузер.
Другие параметры SSL можно проверить с помощью этого теста, кроме этого легко гуглится ещё много подобных сервисов.

Дополнительно

Естественно, все демоны после изменения конфигов релодятся или рестартятся.

PS: Разработчики nginx отключили SSLv3 в конфигах. На новых версиях этого делать уже не требуется.

Экономные дифференциальные бэкапы с hard links

Часто возникает задача делать backup больших объемов редко изменяющихся файлов. Обычно для этого используют замечательную утилиту rsync, которая синхронизирует обновленные файлы, чем существенно экономит время бэкапа и сетевой траффик. Количество копий бэкапа, на которые происходит синхронизация, произвольно и чем оно больше — тем лучше. Естественное ограничение — свободное местом носителя. И здесь на помощь приходят две полезные опции рсинка:

--compare-dest=DIR also compare received files relative to DIR
--link-dest=DIR hardlink to files in DIR when unchanged

Первая из них создает чисто дифференциальный бэкап сравнением с существующим, то есть помещает в новый бэкап только изменившиеся файлы. Вторая — создает полный бэкап, при этом не изменившиеся файлы с помощью hardlinks ссылаются на забэкапленные. В плане использования свободного места бэкапного сервера различия несущественны, но чисто дифференциальный для использования требует наличия директории сравнения. Основанный на hardlinks — можно сразу использовать «как есть», что намного удобнее. Поэтому, будем рассматривать вариант именно с жесткими ссылками.

Логика бэкапов сделаем наподобие logrotate. Новая директория добавляется с номером 0, при этом существующие сдвигаются на +1 вперед. Количество бэкапов ограничим: последняя директория будет удаляться. Получаем следующий скрипт:

#!/bin/sh

servname="mailserv"

backup_dir=/backup/$servname/vmail
len=60

tmpname=--temp--

curr_dir="$backup_dir/$tmpname"
zero_dir="$backup_dir/`printf "%02d" 0`"
prev_dir="$backup_dir/`printf "%02d" 1`"

last_dir="$backup_dir/`printf "%02d" $len`"

date=`date`
echo "Starting backup: $date."

if [ -d "$zero_dir" ]; then
	echo "Rotating directories up to $len."

	# removing last directory
	if [ -d "$last_dir" ]; then
		rm -rf "$last_dir"
	fi

	# rotating
	for i in $(seq  $len -1 0); do
		src="$backup_dir/`printf "%02d" $i`"
		if [ -d "$src" ]; then
			mv "$src" "$backup_dir/`printf "%02d" $(($i+1))`"
		fi
	done
fi

if [ -d "$curr_dir" ] ; then
	echo "Warning: \"$curr_dir\" already exists. Probably it was not renamed during last run. Resuming it."
fi


if [ -d "$prev_dir" ] ; then
	echo "Making hard-linked incremental backup."
	rsync -rtzKL --delete --stats --link-dest="$prev_dir" -v $servname:/var/vmail "$curr_dir"
#	rsync -rtzKL --delete --stats --compare-dest="$prev_dir" $servname:/var/vmail "$curr_dir"
else
	echo "Making init backup."
	#rsync -rtzKL -e "ssh -i /home/bu/.ssh/id_dsa" --delete --stats $servname:/var/vmail "$curr_dir"
	rsync -rtzKL --delete --stats $servname:/var/vmail "$curr_dir"
fi

# moving temporary to latest
mv "$curr_dir" "$zero_dir"

echo "Backup finished: $date."
echo "================================="
echo ""

В результате на файловой системе с поддержкой жестких ссылок можно разместить бэкапов размером на порядки больше, чем размер самого носителя. Например бэкап почтового сервера размером ~870 Gb состоящий из 30 копий занимает всего 970 Gb.

PS: Для систем с разделением прав доступа и разными пользователями такой бэкап желательно делать с опцией --numeric-ids, которая сохранит (цифровые) owner:group.

SSD на серверах

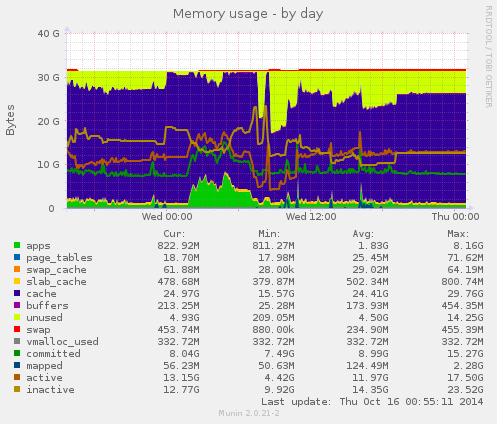
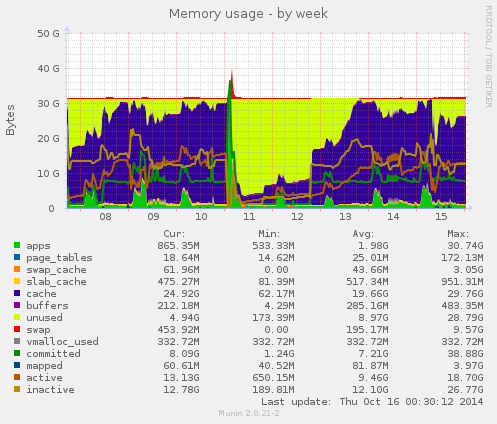
memory-day memory-week

Сколько было сказано о бестолковости использования SSD на серверах, народ всё равно продолжает брать. Действительно полезен SSD лишь на очень узком круге круге задач, где требуется быстрый рандомный доступ к памяти на чтение. В остальных случаях прирост лучше обеспечивается или быстрыми RAID или увеличением RAM. Кому интересно почему последнее работает  — гуглит Page Cache.

В качестве примера выше приведены графики использования памяти (день, неделя) на типичном веб-сервере. Фиолетовая часть и есть тот самый кеш, который снижает нагрузку на input-output. На недельном графике на 11 число приходится перезагрузка, после которой кеш в последующие дни медленно наполняется.

Основы безопасности сайта

В последнее время распространена проблема автоматизированного взлома сайтов на известных CMS. Целью взлома обычно является: рассылка с сайта спама и размещение ссылок на внешние ресурсы. Несмотря на то, что проблема обычна вызвана уязвимостями в самой CMS, она может быть решена в общем виде.

Для решения как минимум нужно обеспечить условия:

  1. Исполняемый код должен быть защищен от записи от пользователя веб-сервера. Наиболее очевидный вариант как это сделать: назначить ему owner:group другого пользователя, от которого и работать с кодом на запись, а веб-серверу оставить права только на чтение.
  2. Запретить исполнение кода во всех директориях разрешенных на запись от веб-сервера (контент, кеш и подобные).
  3. Забыть про ftp и не сохранять пароли в файловых менеджерах. Взамен пользоваться scp/sftp, желательно с авторизацей по ключу.
  4. Для разных virtual hosts использовать разных системных пользователей, которые не читают данные друг друга.

Первый пункт из вышеприведенных гарантирует сохранность кода, даже в движке с дырами или бэкдором. Второй затрудняет исполнение залитых файлов: их можно исполнить с помощью include(), но для этого в read-only коде должна быть такая возможность (которая по сути является бэкдором).

Кроме этого, желательно:

  • Ограничить доступ в административные части сайта по IP-адресам на уровне веб-сервера только с рабочих компьютеров. Способ помогает даже при компрометации паролей, а также при человеческих конфликтах.
  • Использовать SSL-соединения (с префиксом https://) для входа в административные части и везде, где используется пароль для входа. Это защитит от компрометации паролей и данных по каналам связи, например при работе по незащищённому вайфаю.
  • Если точек входа на сайт небольшое количество, разрешить использовать только их, остальное запретить.

Проверка rar в amavis на почтовом сервере

Оказывается, стандартный unrar-free не распаковывает многоуровневые вложенные rar-архивы. Для того, чтобы такие архивы распаковывались и их содержимое проверялось необходимо включить «несвободную» unrar-библиотеку. Если конкретно, то изменить в конфиге amavis стоковую конфигурацию (которая находится в /etc/amavis/conf.d/01-debian:

#$unrar = ['rar', 'unrar']; #disabled (non-free, no security support)
$unrar = ['unrar-free'];

на свою:

$unrar = ['rar', 'unrar']; #disabled (non-free, no security support)
#$unrar = ['unrar-free'];

После этого амавис корректно открывает rar-архивы и можно запрещать неугодные разрешения файлов.

UPDATE:
Если закомментировать обе строки, то будет использоваться архиватор 7zip (который заранее, естественно, установить надо). Также его можно указать вручную. Это похоже наилучшее решение.